このエントリは2026/06/16現在の情報に基づいています。将来の機能追加や変更に伴い、記載事項からの乖離が発生する可能性があります。
問い合わせ
定期連絡(pingとも言う)のような問い合わせが届いた。
最近AnthropicモデルもMicrosoft Foundryから利用可能になったと聞いているが、API ManagementのバックエンドサービスとしてAnthropicモデルを配置した場合にログや消費トークン数は採取できるか?もちろんOpenAI互換APIであれば取得できるのは理解しているが、Native APIのサポート状況を知りたい。
この質問をしてきた主は、過去に問い合わせてきた主(いつもの主である)。
「時間が経過しているし、Foundry経由でモデルも利用できるようになっているのだから、それなりに対応しているはずだよねぇ(チラ」ということのよう。確かに状況が変わっているので、確認しておいて損はしなさそうである。
サポート状況
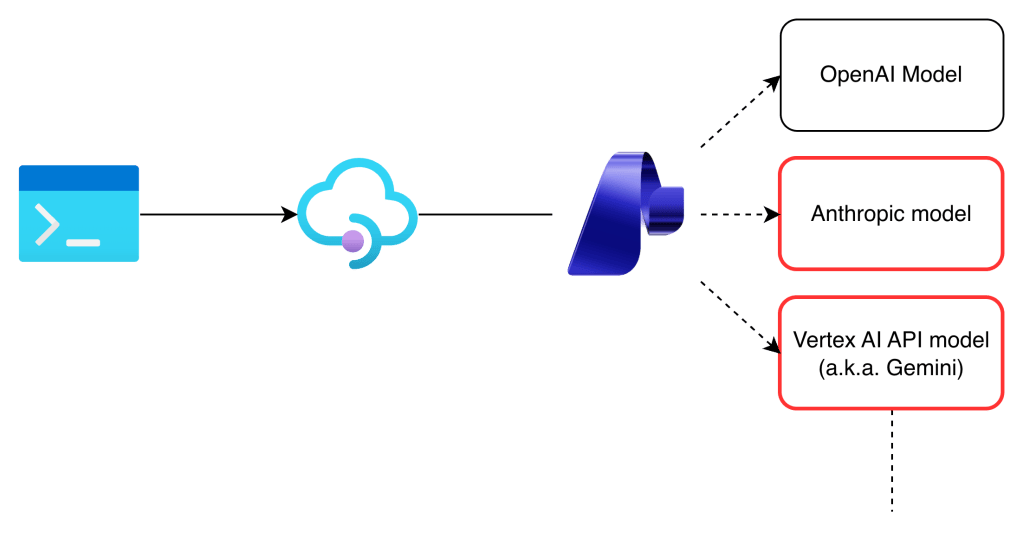
ドキュメントを見ると、API ManagementのAI Gateway機能として、AnthropicモデルのMessages APIはAPI Management v2でサポートされていることが明記されている。
AI ゲートウェイを使用して、次のようなさまざまな AI エンドポイントを管理します。
- 次のいずれかの API スキーマに準拠する言語モデル API:
- OpenAI チャットの完了または応答 API
- Anthropic Messages API (現在、API Management v2 レベルでサポートされています)
- Google Vertex AI API
Use the AI gateway to manage a wide range of AI endpoints, including:
- Language model APIs that conform to one of the following API schemas:
- OpenAI Chat Completions or Responses API
- Anthropic Messages API (currently supported in API Management v2 tiers)
- Google Vertex AI API
Azure API Managementの AI ゲートウェイ / AI gateway in Azure API Management
https://learn.microsoft.com/azure/api-management/genai-gateway-capabilities
Vertex AI APIは現在のGemini Enterprise AI Platformで提供されるモデル全体ではなく、Gemini Enterprise Agent Platform 側に移行したネイティブ Gemini 推論 API 形式を指す。この内容であれば、所望の機能も使えそうに思えるが、果たして…。
環境
前回と同じ環境、といいたいところだが、今回はOpusではなくHaikuを使った。その他の条件は同じ。
| リソース | 利用したもの | 備考 |
|---|---|---|
| APIM | Standard V2 | V2であればどのSKUでも実現可能 診断設定は構成済み |
| LLM | Claude Haiku 4.5 (20251001) (Anthropic) | Messages APIを利用 https://platform.claude.com/docs/en/api/messages |
前回と同じく、AnthropicはOpenAPI Specを公開していないので、Messages APIをAPIMに手動で登録しておく。このあたりは前回のエントリを参照していただきたい。API KeyはBackendsで設定してもよいし、ポリシーで設定してもよい。例によってAPI Keyを設定するにあたっては、Header keyが違うので注意。
環境設定はこれでおしまい。
試してみる
今回は以下のようなリクエストを使うことにした。なお、1回はStreaming有効化したもの、もう一方はStreamingを無効化したもの(以下のリクエストで"stream": falseに変更、もしくはstreamを削除)を投げた。ログの採取有無を確認することが優先なので、出力結果に対する評価はしないのは前回と同様。
{
  "model": "claude-haiku-4-5-20251001",
  "max_tokens": 64000,
  "stream": true,
  "system": "You have an expertise in Azure architecture. Your responsibility is to articulate and elaborate queries and provide the best architecture following Azure Well-architected Framework.",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "type": "text",
          "text": "SharePoint OnlineからファイルをBoxに移送する手段として、一番コストが安い方法を提示して。"
        }
      ]
    }
  ],
  "thinking": {
    "type": "enabled",
    "budget_tokens": 63999
  }
}
確認する
Log Analytics WorkspaceでApiManagementGatewayLlmLogにログが出ているかどうかを確認する。
Stream有効時

Stream無効時

どちらも問題なくログならびにトークン消費量がログに書き込まれていることがわかる。Stream有効時には、IsStreamCompletionがtrueになっていることもわかる。
更問が届く
例によって更問が届いた。ま、知りたくなるのはわかる。
Prompt cachに関するトークン使用量はログに記録される?できればログに出てるとうれしいけど、そうでなくても、カスタムメトリックで取得できたらうれしい。
キャッシュ関連のtoken usageは、以下の3行目から7行目のあたり。
"usage": {
    "input_tokens": 3,
    "cache_creation_input_tokens": 184,
    "cache_read_input_tokens": 10564,
    "cache_creation": {
        "ephemeral_5m_input_tokens": 184,
        "ephemeral_1h_input_tokens": 0
    },
    "output_tokens": 160,
    "service_tier": "standard",
    "inference_geo": "not_available"
}
Streamが有効であれば、最後のdeltaで以下のようなメッセージが飛んでくる。
{
    "type": "message_delta",
    "delta": {
        "stop_reason": "max_tokens",
        "stop_sequence": null,
        "stop_details": null
    },
    "usage": {
        "input_tokens": 3,
        "cache_creation_input_tokens": 198,
        "cache_read_input_tokens": 10743,
        "output_tokens": 160
    }
}
これらの情報がどこかで確認できるか、というのが主たる問い合わせ。
確認する
1. ログに出ているか?
これはNo。上記の通りで、ApiManagementGatewayLlmLogではフィールドが存在しないので、ログテーブルには保存されない(今後の対応に期待したいところ)。
2. カスタムメトリクスで捕捉できるか?
llm-emit-token-metricポリシーでカスタムメトリクスをApplication Insightsに投げ込めるのだが、Application InsightsのcustomMetricsテーブルからトークン利用状況を確認できるか、ということ。これへの回答は「一部の情報は出ている」。一部の情報、具体的にはcache_creation_input_tokensおよびそれに関する情報は抜け落ちてしまっている。
Streaming有効時
customMetricsテーブルの内容はこちら。
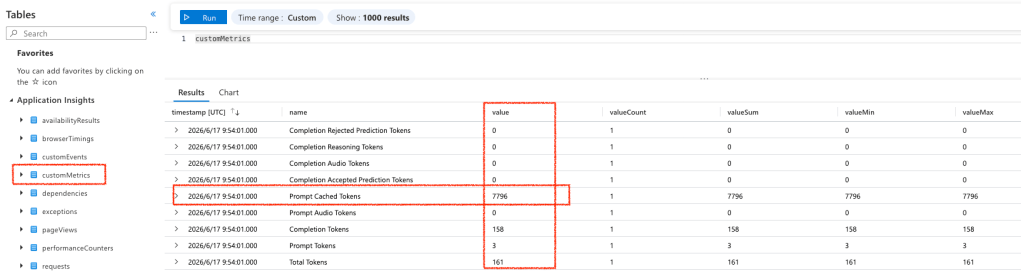
2026/6/17 9:54:01 (UTC) におけるdeltaは以下の通り。
{
    ...,
    "usage": {
        "input_tokens": 3,
        "cache_creation_input_tokens": 184,
        "cache_read_input_tokens": 7796,
        "output_tokens": 158
    },
    ...
}
比較すると以下の通り。cache_creation_input_tokensは取得できていないが、cache_read_input_tokensは取得できていることがわかる。
| delta | customMetrics |
|---|---|
| input_tokens (3) | Prompt Tokens (3) |
| cache_creation_input_tokens (184) | N/A |
| cache_read_input_tokens (7796) | Prompt Cached Tokens (7796) |
| output_tokens (158) | Completion Tokens (158) |
Streaming無効時
同様にStreaming無効時も確認しておく。
customMetricsテーブルの内容はこちら。
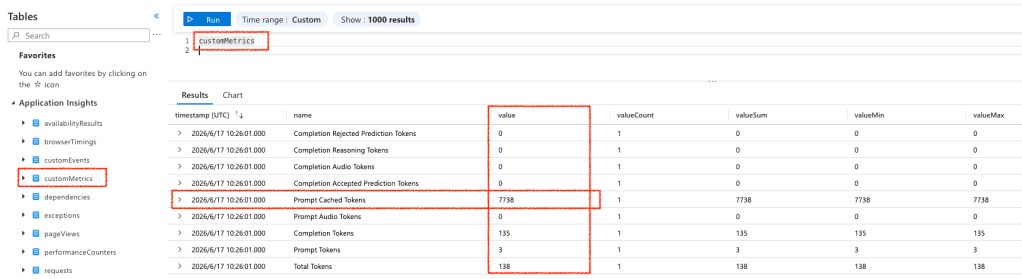
2026/6/17 10:26:01 (UTC) のToken usageは以下の通り。
{
    ...,
    "usage": {
        "input_tokens": 3,
        "cache_creation_input_tokens": 155,
        "cache_read_input_tokens": 7738,
        "cache_creation": {
            "ephemeral_5m_input_tokens": 155,
            "ephemeral_1h_input_tokens": 0
        },
        "output_tokens": 135,
        "service_tier": "standard",
        "inference_geo": "not_available"
    },
    ...
}
| response prompt | customMetrics |
|---|---|
| input_tokens (3) | Prompt Tokens (3) |
| cache_creation_input_tokens (155) cache_creation.ephemeral_5m_input_tokens (155) cache_creation.ephemeral_1h_input_tokens (0) | N/A |
| cache_read_input_tokens (7738) | Prompt Cached Tokens (7738) |
| output_tokens (135) | Completion Tokens (135) |
cache_creation_input_tokensに関連するephemeral_5m_input_tokensやephemeral_1h_input_tokensの値は捕捉できていないが、その他はStreaming有効時と同様。
注意
llm-emit-token-metricポリシーはイベント発生の都度メトリックを送信するが、Application Insightsの分解能は60秒。つまりApplication Insightsは最小60秒、つまり1分間隔での出力までしかできないので、同じディメンジョンを使っていると、60秒の間に着信したすべてのメトリックを加算してしまう点に注意が必要。今回は簡単のために、60秒ごとにターンを回すテストアプリケーションを作成し、挙動を確認している。
ひとまずMessages APIでもToken usageを取得できることがわかったので、今度はGoogleのVertex AI APIでも同様にログを取得できることを確認する。結果は後日。
 Logico Inside
