このエントリは、2026/10/08現在の情報に基づいています。将来の機能追加や変更に伴い、記載事項からの乖離が発生する可能性があります。
問い合わせ
例のいつもの人から以下のような問い合わせが届いた。
OpenAIモデルを、現在Global StandardデプロイメントでSweden CentralとEast US 2に配置している。負荷分散しながらリクエストを投げ込みたいが、注意すべきことを教えてほしい。APIも以前と異なりResponses APIなので、以前とは異なり考慮すべき点があるのだろう、と考えている。
いつも通りなんともざっくりした質問であるが、「以前はAzure API Management (APIM) を使ってラウンドロビンで振り分けるだけでもよかったが、今もそうなのか?」という疑問らしい。
デプロイメントの種類
デプロイメントの種類は、以下のドキュメントに記載がある。ドキュメントに記載の通り、Sweden CentralとEast US 2にデプロイしたモデルと言っても、Global Standardを使っている時点で、実際に当該リージョンで処理されるとは限らない。
Understanding deployment types in Microsoft Foundry Models – Microsoft Foundry | Microsoft Learn
Data Zone Standardの場合は、指定のデータゾーン(例えば東日本リージョンにデプロイしたモデルであれば、APACデータゾーン)でデータ処理される。
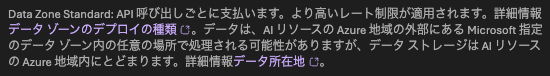
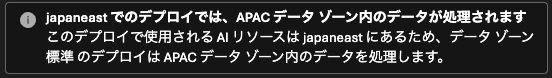
StandardやRegional Provisionedであれば、データ処理は当該リージョンで実施される。
上記を踏まえると、以下のようにまとめることができる。
- すべてのデプロイメントで、Responses APIなどの機能で自動的に保存されるデータは、AIリソースの存在するAzureリージョンにとどまる。
- データ処理場所については以下の通り。
- Global Standardデプロイメントでは任意のリージョンでデータ処理されるため、どのAzureリージョンでデータ処理されるか利用者側ではわからない。
- Data Zone Standardデプロイメントでは、データゾーン内で処理されるが、この場合もどのAzureリージョンでデータ処理されるかは利用者側ではわからない。
- Standard、Regional Provisionedデプロイメントでは、データ処理場所がリソースをデプロイしたAzureリージョンに一致する。
- Global Standardデプロイメントでは、リソースデプロイ場所が異なっていても、データ処理場所が一致する場合があるため、厳密な意味での負荷分散ができているかどうかは判断できない。
それゆえ、どうしてもデータゾーンやリージョンで閉じるようにしたいなら、明示的にデプロイメントで指定する必要がある(この主の場合、新しいモデルを使うときに原則Global Standardを採用していたので、デフォルトのまま指定していたよう)。
各リージョンへの振り分け
「複数リージョンへの分散によって、アプリケーションにどのような影響があるか、何か変更すべき箇所があるか?」というのも今回の問い合わせに含まれている。問い合わせ主のアプリでは、以前はAzure OpenAIのAPIを使っていたが、現在はOpenAIのResponses APIを使っている。
Data Zone StandardもしくはStandardデプロイメントでモデルをデプロイしたとして(もちろんGlobal Standardでもいいが、上記の注意点は認識しておく必要がある)、APIM (=AI Gateway) を使って分散させることになるが、少々注意点がある。
Responses APIの場合、デフォルトではStatefulなので、
previous_response_idを使って、同じモデルと対話する前提で動作- 応答はデフォルトで保存(バックエンド実行の場合は保存必須)
するという特性がある。もしAPIMが本来の対話モデルでない、別のモデルにルーティングすると、当該対話がリソースにない、ということで400を返す。複数デプロイメントに分散するのであれば、以下のような対策が必要がある。
APIMを使った負荷分散や振り分けはアーキテクチャセンターに詳細が記載されている。
1. LLMモデルリソースにStateを持たせる場合
APIMのBackend poolでSession affinityを構成して、一度応答したリソースに必ず到達するようにする。
Azure API Management Backends | Microsoft Learn
実際に再現できるサンプルがあるので、確認することを推奨する。アフィニティなしでは会話が壊れ、Cookie によるアフィニティで解消する様子を再現している。
AI-Gateway/labs/session-awareness at main · Azure-Samples/AI-Gateway
Session IDのCookieを発行するために、クライアントは Set-Cookie の値を保存し、以降のリクエストで送り返す必要がある。
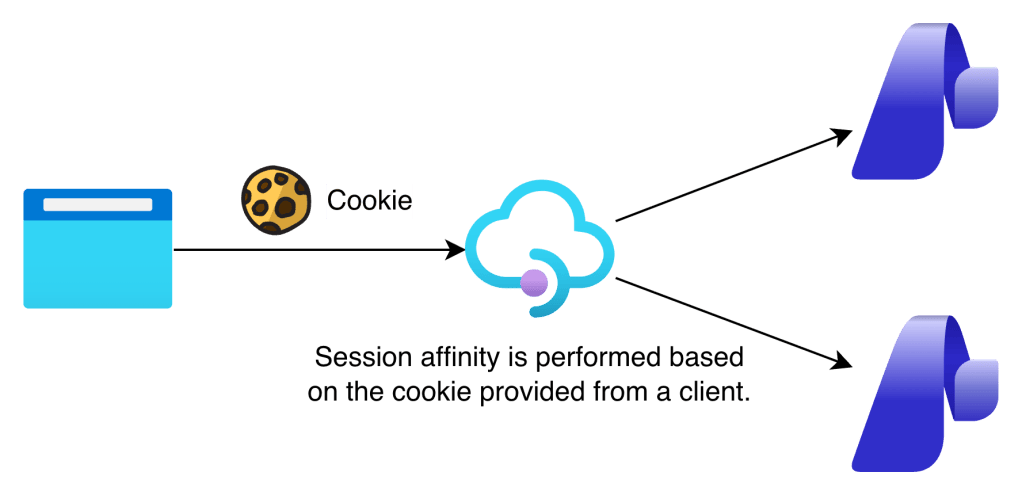
注意点は、previous_response_idを使っていてモデルから429が返ってきた場合、別リージョンのモデルに振り分けず、429をクライアントに返すように構成すべきである。429でCircuit breakerを構成していると、別のLLMモデルリソースに転送されるため、結果として400が返ってきてしまうからである。
2. LLMモデルリソースにStateを持たせない
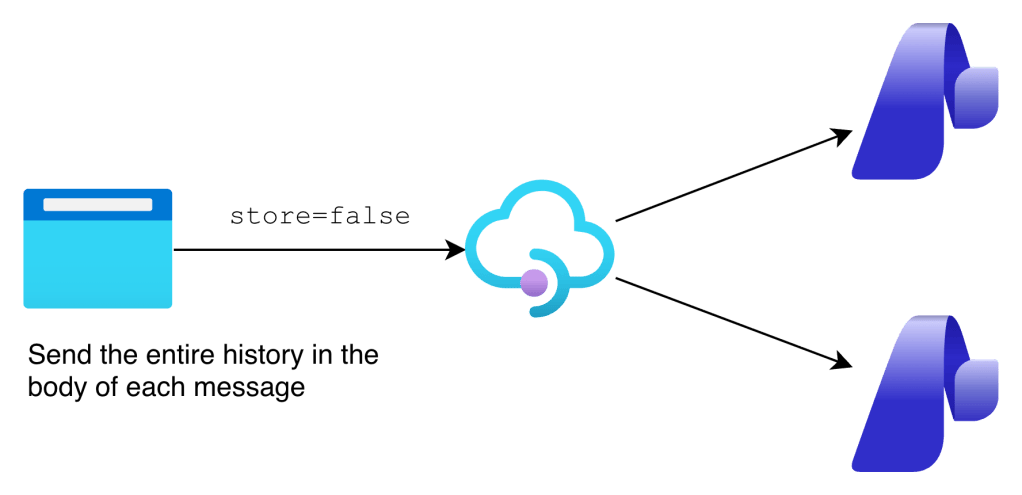
previous_response_idを使わないのであれば、モデル側に状態を持たせず ("store": false)、逐一メッセージ本文で全履歴を送信する。推論を引き継ぐのであれば、include に reasoning.encrypted_content を指定する。
Migrate to the Responses API | OpenAI API
Reasoning models | OpenAI API
これであれば、Stateをクライアントアプリケーションが保持・管理するため、APIMでどこに振り分けられても問題ない。ただしクライアントアプリケーションの処理が遅くならないように設計・実装する必要がある。
まとめ
今回の問い合わせに対しては以下のように回答した。
- 厳密な負荷分散ということなら、Global Standardではなく、Data Zone StandardもしくはRegional Standardの採用を推奨する。
- Responses APIのデフォルトはStateをLLMモデルリソースで保持し、
previous_response_idを使う。そのため
- 最初に対話したLLMリソースモデルにセッション固定する必要がある。
- APIMで振り分けている場合は、Session affinityを構成し、クライアントアプリケーションにCookieを渡すように構成することを推奨する。
- それに伴いクライアントアプリケーションもCookieを取り扱うように変更する必要がある。
- Stateをクライアントアプリケーション側(実際には中間層かもしれないが)で保持し、Stateless APIとしてResponses APIを使う場合には、
- LLMモデルリソースに状態を持たせず (
"store": false)、逐一メッセージ本文で全履歴を送信する。- 推論を引き継ぐ場合は、
includeにreasoning.encrypted_contentを指定する。

コメントを残す